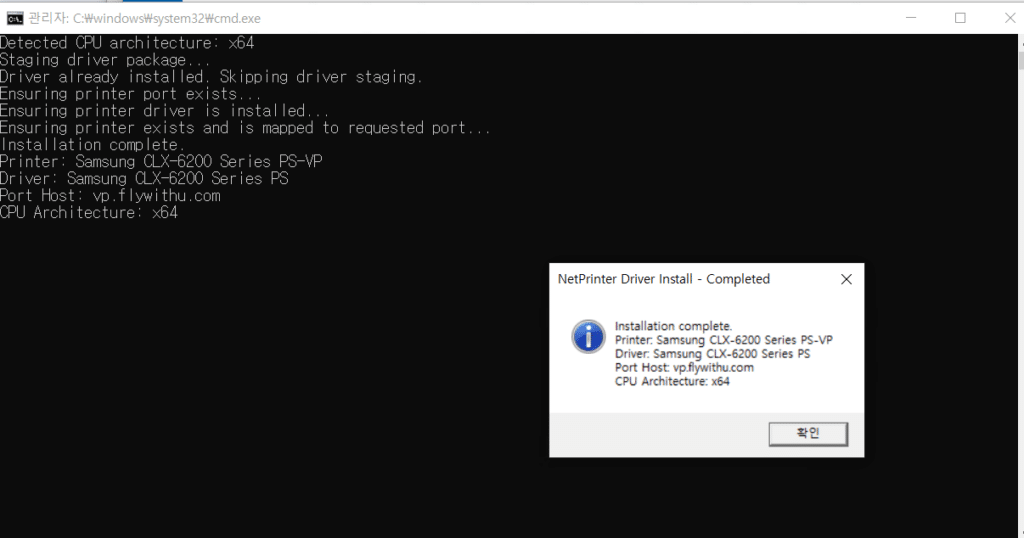
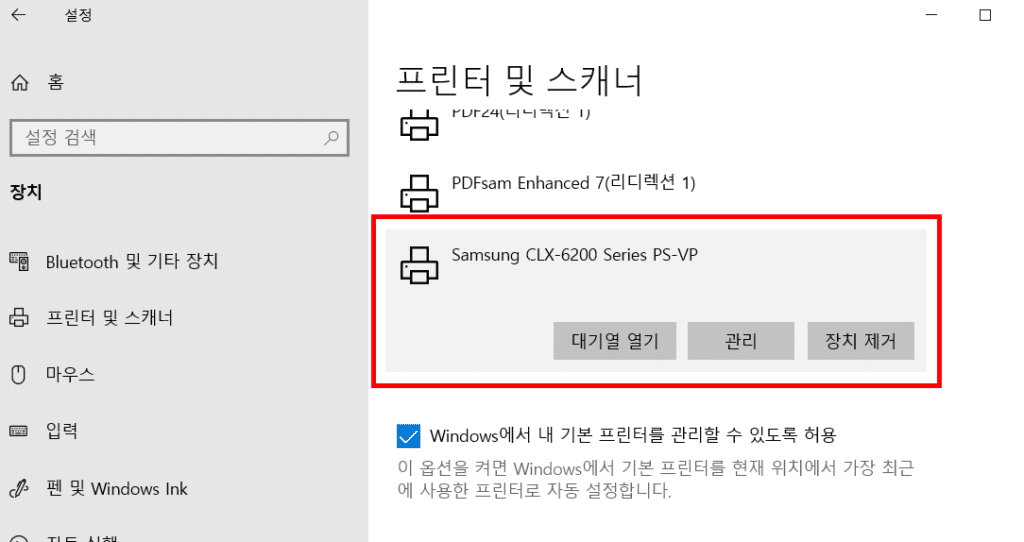
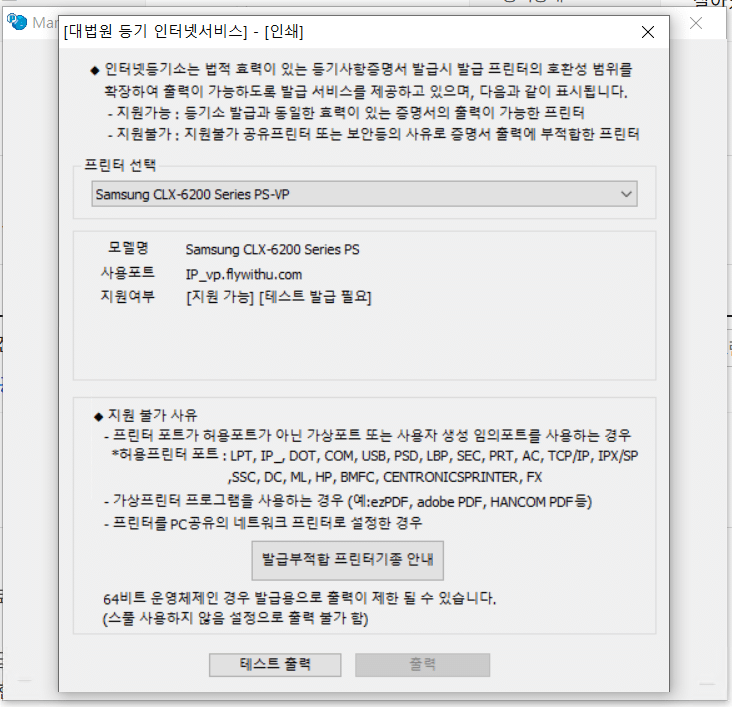
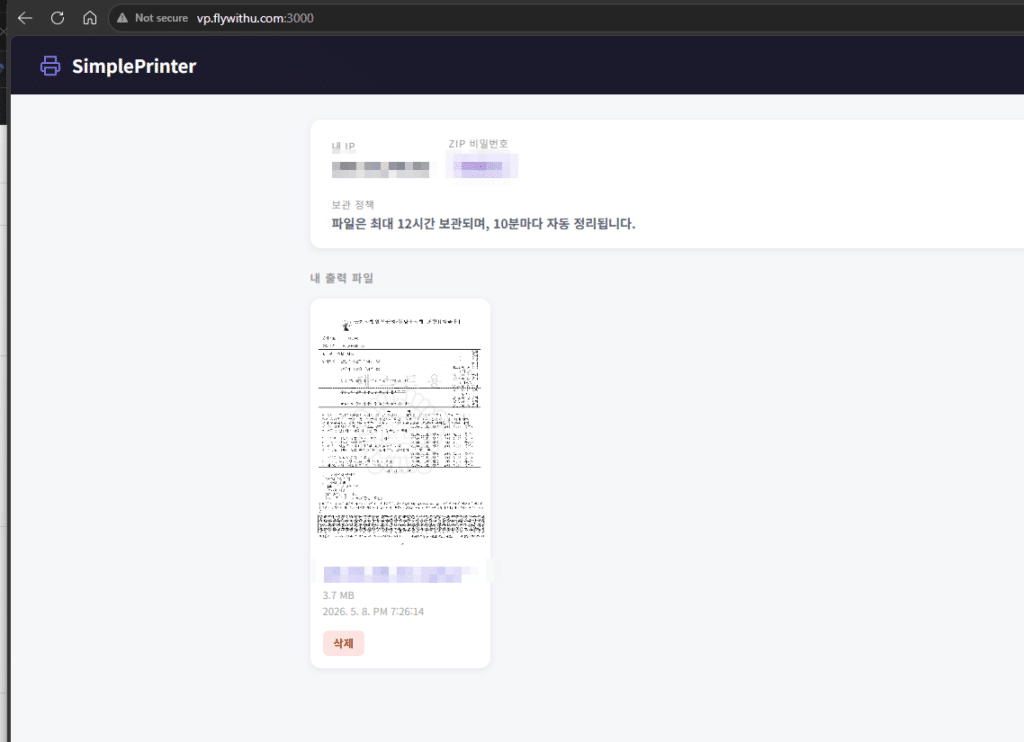
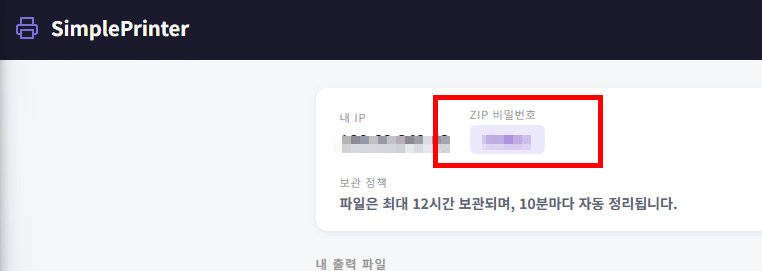
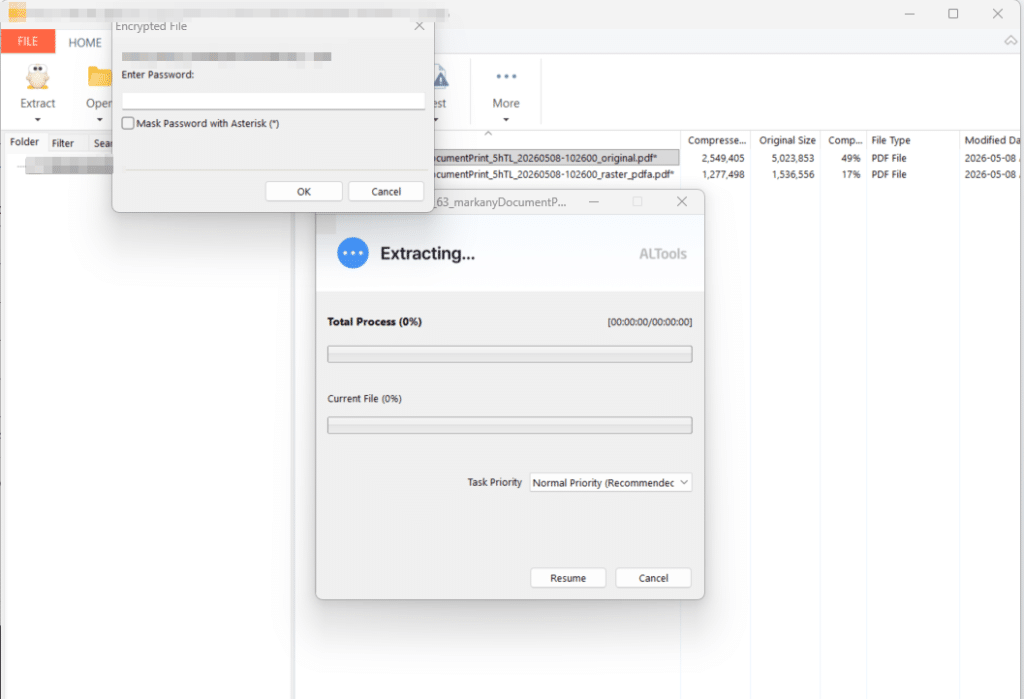
사용 메뉴얼은 기존과 동일합니다. 단 ipv4 (집에서 인터넷) 환경이 안정적입니다. 핸드폰 테더링은 계속 ip주소가 변경이 됩니다. 다만 프린터 드라이버의 서버 주소를 vp.flywithu.com 으로 변경해 주시길 요청드립니다. 기존 주소도 사용은 가능하지만, DNS 캐싱 등으로 인한 예기치 않은 오류를 줄이기 위해 새로운 주소로 설정해 주시는 것을 권장드립니다.
설치 및 사용에 대한 자세한 내용은 기존 Virtual Print 메뉴얼 글을 그대로 참고하시면 됩니다.
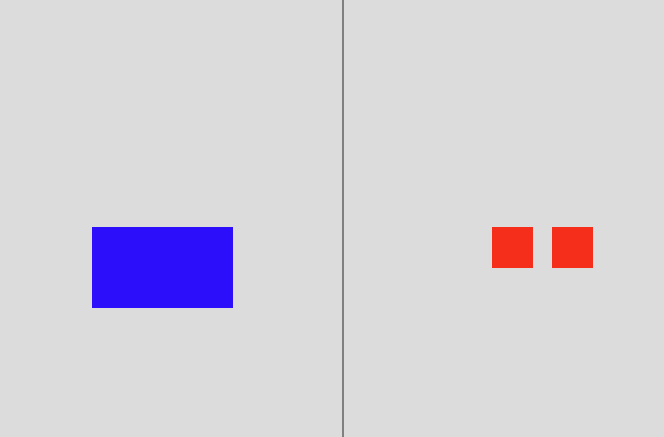
a. 일차 설계 왼쪽에 1개, 오른쪽에 2개를 놓아보았다. 그리고 물었더니 왼쪽/오른쪽 너무 잘 대답해준다.
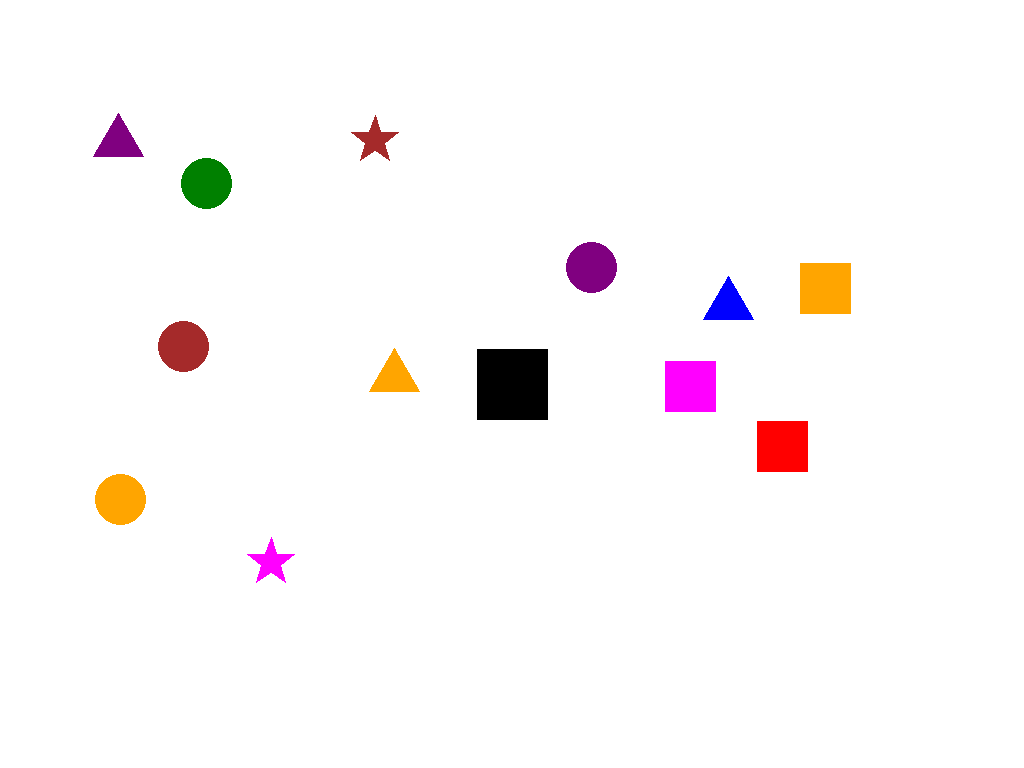
b. 최종 설계 아래 프롬프트와 같이, 가운데 블랙 박스를 놓고 그것을 기점으로 좌우를 비교 해달라고 했다. 블랙스퀘어 위아래 방향으로는 Deadzone을 놓아서, 좌우를 좀 더 명확하게 만들었다. 결과는 Qwen은 정답률이 30%대까지 낮아졌다. 이제 Cloud VLM을 사용해볼만하다고 생각했다.
prompt = (
        "Look at the black square in the center. "
        "Count every single individual colored object on its LEFT side and every single individual colored object on its RIGHT side. "
        "Which side has more total objects? Answer 'left', 'right', or 'equal' only."
    )
b.1 설계 의사 결정 근거
검은박스: 1차 테스트에서 왼쪽/오른쪽을 너무 잘 맞혔다. 문제를 어렵게 하기 위해 명확한 기준점(검은 박스)를 중앙에 배치했다. 이렇게 하니 Qwen의 정답률이 30%로 급락했다.
Deadzone: 블랙박스 위아래를 완전히 비워서 오직 좌우만 비교 하도록 강제
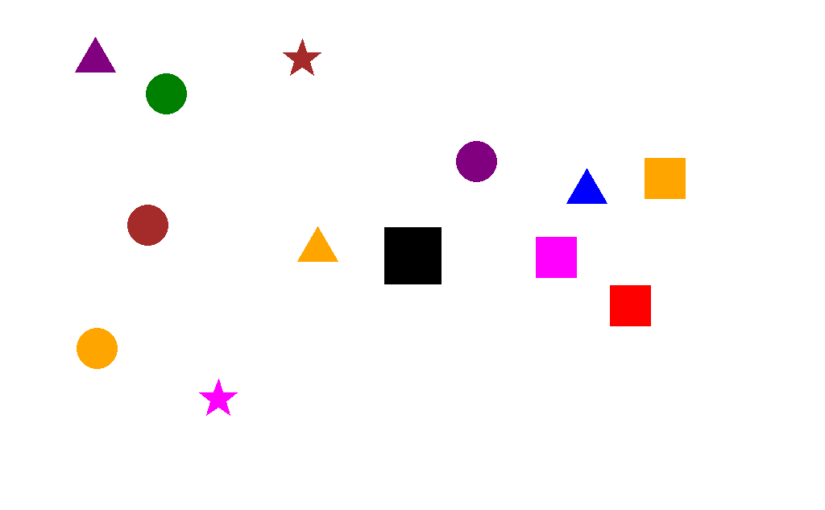
최종 테스트 이미지 예시 – 모든 테스트 이미지는 본 블로그 최하단에 있습니다.
2. 테스트 모델
복수 모델 테스트 가능한 Lightning.AI API이용
매달 Credit 을 주고 있고, 자체 SDK 도 지원
Grok이 없어서 아쉬움 – 자율주행에 최적화된 Tesla의 Grok은 좌우 인식에 최적화되었을 가능성이 높다.
GPT 5.2, Gemini 2.5/3.5 Pro, Claude Sonnet 4.5 선택
3. 1차 테스트 결과
Gemini vs. GPT
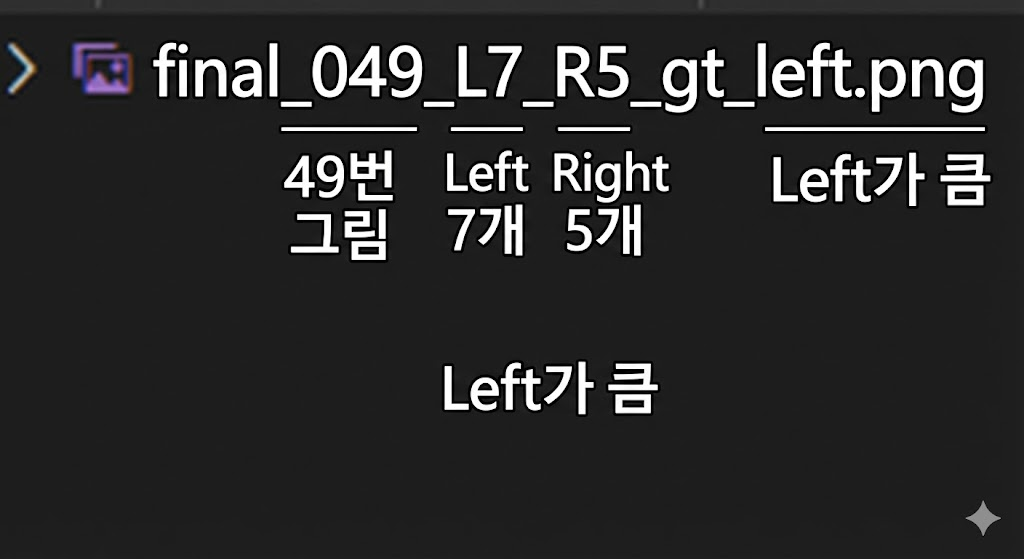
파일 이름의 의미는 아래와 같다. 왼쪽 7개, 오른쪽 5개, 왼쪽이 큼.
Claude 의 답 – left/right로 답변하라는데 저렇게 장황하게 답변을 한다. 그냥 알아서 매우 자세하게 분석해서 답변을 한다. 이래서 Claude가 코딩을 잘하나.
    "final_000_L8_R4_gt_left.png": {
        "filename": "final_000_L8_R4_gt_left.png",
        "gt": "left",
        "pred": "left",
        "correct": true,
        "full_response": "I need to identify the black square in the center and count the colored objects on each side.\n\nThe black square is located in the center of the image.\n\n**Objects on the LEFT side of the black square:**\n1. Purple star (top left)\n2. Magenta/pink star (upper center-left)\n3. Red star (upper center-left, below the magenta star)\n4. Blue star (center-left)\n5. Red star (left side)\n6. Blue circle (below and left of black square)\n7. Red circle (below and left of black square)\n8. Red circle (below and left of black square, lowest)\n\nTotal on left: 8 objects\n\n**Objects on the RIGHT side of the black square:**\n1. Cyan star (upper right)\n2. Magenta square (upper right)\n3. Purple square (right of black square)\n4. Purple triangle (lower right)\n\nTotal on right: 4 objects\n\n**Answer: left**"
    },
Gemini 3.5의 답 – Claude 처럼 분석적으로 문제를 푼다. 그러나 난 left/right 로 답하라 했는데.
    "final_000_L8_R4_gt_left.png": {
        "filename": "final_000_L8_R4_gt_left.png",
        "gt": "left",
        "pred": "left",
        "correct": true,
        "full_response": "To determine which side has more objects, let's count them relative to the central black square.\n\n**Left Side Objects:**\n1.  Purple star (top left)\n2.  Pink star (top, slightly left of center)\n3.  Red star (middle left)\n4.  Blue star (middle left)\n5.  Red star (middle left, lower than blue one)\n6.  Blue circle (below the stars)\n7.  Red circle (bottom left)\n8.  Red circle (bottom left, lowest one)\n\nTotal on the left: **8**\n\n**Right Side Objects:**\n1.  Cyan star (top right)\n2.  Magenta square (top right)\n3.  Purple square (middle right)\n4.  Purple triangle (bottom right)\n\nTotal on the right: **4**\n\nComparing the two counts (8 vs 4), the left side has more objects.\n\nleft"
    },
동일함 이미지와 동일한 Prompt에서 모델별 성능차이가 많았다. Claude 와 Gemini3.5 는 주절주절 말해서 탈락 시켰다. 난 분명히 ‘Answer ‘left’, ‘right’, or ‘equal’ only.’ 라고 말했다. 이러한 포맷 정확성/유지는 특히 자동화에서 매우 중요하다.
총 96개의 이미지를 테스트했고, Gemini는 91점, Gpt는 48점으로 Double Score의 차이가 났다. 단 추론 시간은 Gemini가 GPT 대비 느렸다. 어쩌면 내부적으로 CoT를 돌리고 결론만 응답했을 수도 있다.
GPT실패한 사유를 보면 좌우를 잘못 보았다고 보기는 어려웠다. 이렇게 left/right 가 바뀌었다기 보다 equal로 (인식 자체를 오류)인 경우가 많았다.
GPT 5.0은 Text 전용 모델이었다. 이 모델에 Vision만 ‘추가’한 형태이지 않을까. 그러다 보니 Vision이 약할 수 있다.
4. 2차 테스트
사실 2차 테스트는 1차 결과를 상세 분석을 안하고, GPT 가 틀린 것이 많다는 결과만 보고 진행했다. 이때는 GPT가 좌우를 인식을 잘못 한 거라고 생각하고 새롭게 테스트를 했다.
Gemini 3.5나 Claude 의 답변을 참고해서, 아래 프롬프트처럼 카운트를 하게 했다. 이렇게 했을 때 91%수준으로 급격한 결과 상승을 했다. 그러나 이것은 내가 설계한 실험 방향과 달랐다.
     prompt = (
     "Look at the black square in the center. "
     "Count every single individual colored object on its LEFT side and every single individual colored object on its RIGHT side. "
     "Determine which side has more objects.\n\n"
    "Return ONLY in the following format:\n"
     "<side> <number>\n\n"
     "Where:\n"
     "- <side> is exactly one of: left, right, equal\n"
     "- <number> is the absolute difference in object counts\n"
     "- If both sides have the same number, return: equal 0\n\n"
     "Do not include any extra text or explanation."
 )
5. 3차 테스트
모델이 이미지를 오독한 게 아니라, 좌우를 오인식 했다는 것을 어떻게 알 수 있을까. 한참 고민을 한 끝에 아래와 같이 프롬프트를 만들었다. 절대적으로 카운트 하는 것이 아니라 어느쪽이 얼마나 크냐? 로 상대적인 것을 물었다. 이렇게 하면 좌우를 잘못 판단하고, 카운트는 제대로 한 것의 유무를 알 수 있을 것이라 생각했다. 이렇게 했을 때는 소폭 상승한 62점을 맞았다.
prompt = ( "Look at the black square in the center. " "Count every single individual colored object on its LEFT side and every single individual colored object on its RIGHT side. " "Determine which side has more objects.\n\n" "Return ONLY in the following format:\n" "<side> <number>\n\n" "Where:\n" "- <side> is exactly one of: left, right, equal\n" "- <number> is the absolute difference in object counts\n" "- If both sides have the same number, return: equal 0\n\n" "Do not include any extra text or explanation.")
아래는 테스트 결과이다.
왼쪽 5개, 오른쪽 6개로 실제로 오른쪽이 많으나, 결과는 왼쪽이 1개 더 많다고 나왔다. 2개를 잘못 카운트 한것이 아니라면, 좌우 오류로 볼 수 있다.
1. Intro 자율주행은 객체 인식을 통해, 판단하고 동작한다고 생각했다. 자율주행이라는 주제가 오래되었고, 데모를 봐도 거의 객체 인식하는 화면이었기 때문이다. 그런데 얼마 전에 자율주행 리크루팅 공고를 보는데 VLM이 있었다. 그것을 보고 'VLM을 자율주행에 사용할 수 있겠구나' 생각이 들었다. 1.1 자율주행에서 윤리가 중요한가? 2018년 Uber의 자율주행 테스트 차량에 의해 보행자 사망사고가 발생했다. 이 사건은 자율주행 기술이 단순히…
이 글에서 다루는 HWP/HWPX 지원 구성은 subinsong 님의 글과 Gemini 도움을 바탕으로 TrueNAS 환경에 맞게 재구성한 것입니다. - Paperless-ngx에서 한글파일 지원하도록 설정하기 1. 인트로 2025년을 마무리하면서 사진과 문서를 정리하고 있습니다. 사진은 photoprism으로 이전 중이고, 문서는 원노트와 paperless-ngx 조합으로 정리하고 있습니다.대부분의 문서류는 pdf와 doc 형식이지만, 아이들 관련 문서처럼 간혹 hwp 파일이 섞여 있어서 hwp까지 함께 관리할…
1. 인트로: 8글자의 시작 대학 시절, 단순 알바의 지루함을 달래기 위해 '앞으로 온라인에서 쓸 아이디나 하나 정해볼까?'라는 생각을 하게 됐다. 한참 고민하다가 떠올린 문장은 'fly with you'였다. 함께 어디를 가고 싶다는 느낌이 좋아서였지만, 그 시절에는 아이디가 8자 제한이라 띄어쓰기를 빼고 'you'를 'u'로 줄여 지금의 'flywithu'를 만들었다. 그때 심심함을 달래려고 정했던 이 아이디를 이렇게 오래 메인…
0. 서론 같은 코드와 프롬프트로 Ask 모드와 Agent 모드를 비교했다 토큰 사용량 차이와, VSCode에서 이를 외국어 공부에 활용하는 방법까지 정리했다 1. AI 사용할 때, Ask vs. Agent Ask Mode: 단일 질문에 대한 일회선 답변에 초점 Agent Mode: 사용자가 목표를 말하면, AI가 플랜을 세우고 여러 단계를 자율적으로 실행하는 모드 빠르게 한 번 물어볼 때는 Ask 모드(검색…
0. 서론 . 셀레니움으로 카드 실적을 자동으로 수집하는 시스템을 운영 중이었습니다. . 매일 정확한 실적 데이터를 카카오톡으로 받을 수 있어서 편했습니다. . 그러나 어느 날 갑자기 삼성카드가 멈추었습니다. . 삼성카드 웹사이트 구조 변경으로 Element 가 바뀐 것이었습니다. . 또 하나씩 Element 를 봐야 하나.. 이런 고민을 AI가 해결해주었습니다. 1. 문제상황: 웹사이트 구조 변경으로 인한 삼성카드…
1. TMAP 점수 테스트 실행 배경 . 지인들과 저녁 식사를 하는데 TMAP 이야기가 나왔습니다.. 대부분 80~90점대인데, 한명만 60점대.. 어떻게 60점대가? 물었더니 브레이크를 자주 밟아서 그런거 같다는 답변. 그래서 궁금해졌습니다. 과연 TMAP은 어떤 요소를 볼까? Play이런 상황 2. TMAP의 점수 영향 요건 . 운전 습관과 운전 환경이 영향을 줍니다.. 습관 - 과속 / 급가속 / 급감속.…
AI 시대의 도래 (Codex 모델들) 이제는 AI 없이 코딩하는 것은 매우 비효율적입니다. 여러 조사 결과처럼 AI 도구들은 개발자의 생산성을 향상시켜 줍니다. 그러나 저처럼 무료 사용자는 Cloud quota를 금방 소진해서, 추가적인 방법이 필요 합니다. 또한 보안이 중요한 프로젝트에서는 코드를 외부로 전송할 수 없어 로컬 LLM이 필수입니다. GPU 없이, AI 사용하기 대형 기업이라면, 자체적인 GPU 센터 및…